Domain beiseitelegen.de kaufen?
Wir ziehen mit dem Projekt
beiseitelegen.de um.
Sind Sie am Kauf der Domain
beiseitelegen.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain beiseitelegen.de kaufen?
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
schreiben, schneiden, ordnen, Fachbücher von Ingke GüntherDas Fachbuch "Schreiben, Schneiden, Ordnen" von Ingke Günther bietet einen tiefen Einblick in die Welt der bildnerischen Textarbeiten. Die Autorin, die Kunstpädagogik und Kunstgeschichte studiert hat, beschäftigt sich in ihren Werken intensiv mit der Verbindung von Schrift und visueller Gestaltung. In diesem Buch werden vorwiegend serielle Arbeiten präsentiert, die sowohl die inhaltliche Bedeutung von Begriffen und Phrasen als auch deren formale Gestalt erforschen. Günther zeigt, wie Schrift als zentrales Element in verschiedenen künstlerischen Kontexten eingesetzt werden kann, und lädt die Leser*innen ein, die vielfältigen Möglichkeiten der Textgestaltung zu entdecken. Ihre Arbeiten sind nicht nur in Galerien, sondern auch im öffentlichen Raum zu finden, was die Relevanz und Vielseitigkeit ihrer Kunst unterstreicht. Dieses Buch ist eine wertvolle Ressource für alle, die sich für die Schnittstelle zwischen Sprache und bildender Kunst interessieren.28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
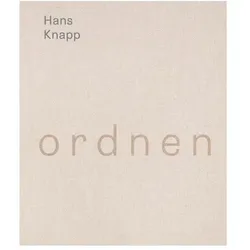
ordnen, Fachbücher von Knapp HansDas Buch "ordnen" von Hans Knapp ist ein einzigartiges Künstlerbuch, das als gedruckter Aggregatzustand eines performativen und sich ständig erweiternden Zeichenraums fungiert. Es dient als Instrument der Navigation, um tief in den Kosmos jahrzehntelanger künstlerischer Arbeit und Tausender Miniaturen einzutauchen. Der Leser wird eingeladen, eigensinnige Umgebungen zu erfahren, wie die Tholos mit integrierten Alphörnern oder die Möbiusschleife, die als Laufband für Sisyphos' Schwester dient. Das Buch regt zum Nachdenken über grundlegende Fragen an, die seit langem beschäftigen, und bietet Reflexionen über Verantwortung, Ästhetik und die Komplexität des menschlichen Daseins. Es ist ein zeichnerisches Werk, das die Gedanken und Überlegungen eines lesenden Künstlers zusammenführt und den Leser dazu anregt, über die Möglichkeiten des eigenen Lebens nachzudenken.49,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
schreiben, schneiden, ordnen, Fachbücher von Ingke GüntherDas Fachbuch "Schreiben, Schneiden, Ordnen" von Ingke Günther bietet einen tiefen Einblick in die Welt der bildnerischen Textarbeiten. Die Autorin, die Kunstpädagogik und Kunstgeschichte studiert hat, beschäftigt sich in ihren Werken intensiv mit der Verbindung von Schrift und visueller Gestaltung. In diesem Buch werden vorwiegend serielle Arbeiten präsentiert, die sowohl die inhaltliche Bedeutung von Begriffen und Phrasen als auch deren formale Gestalt erforschen. Günther zeigt, wie Schrift als zentrales Element in verschiedenen künstlerischen Kontexten eingesetzt werden kann, und lädt die Leser*innen ein, die vielfältigen Möglichkeiten der Textgestaltung zu entdecken. Ihre Arbeiten sind nicht nur in Galerien, sondern auch im öffentlichen Raum zu finden, was die Relevanz und Vielseitigkeit ihrer Kunst unterstreicht. Dieses Buch ist eine wertvolle Ressource für alle, die sich für die Schnittstelle zwischen Sprache und bildender Kunst interessieren.28,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.